← Дайджест от 16 сентября 2026
Исследования
 2 источникаHN 409
Небольшая модель обошла планировщик PostgreSQL на 81% — на запросах из обучения
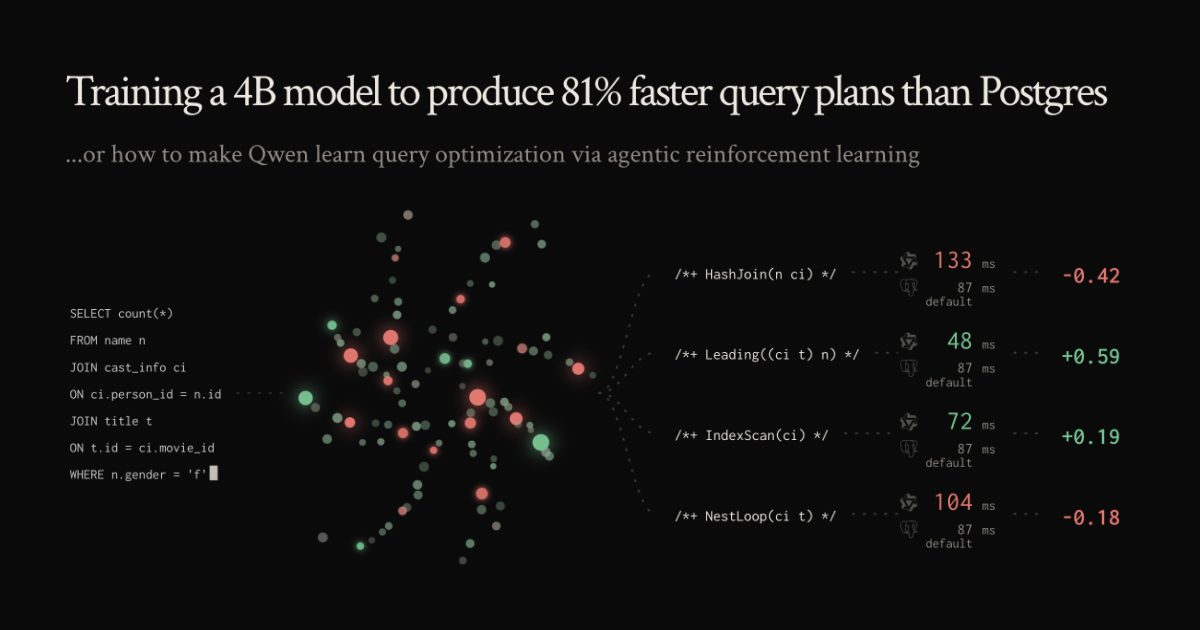
Разработчик Рохан Бансал обучил модель на 4 млрд параметров строить планы выполнения SQL-запросов и получил планы, которые работают на 81% быстрее, чем у планировщика самой PostgreSQL. План запроса — это выбор порядка соединений и способов доступа к данным; обычно его считает встроенный оптимизатор базы по статистике.
Обучение шло через подкрепление: модель предлагала план, база измеряла фактическое время, результат возвращался как награда. Размер модели позволяет держать её рядом с базой, без обращения к внешнему API.
Работа вышла в топ Hacker News с 409 очками; в обсуждении указывают, что выигрыш замерен на конкретном наборе запросов, и переносимость на другие схемы данных из публикации не следует.
Что говорят
refibrillatorHacker News
«На 81% быстрее планов, чем у Postgres» — на датасете 8 ГБ, который целиком влезает в память, с урезанным shared_buffers, прогретыми перед замером запросами и только на SELECT'ах. Я бы опасался переобучения: неясно, будут ли эти планы лучше эвристик Postgres на масштабе и на более реалистичной OLTP-нагрузке.
SomeoneHacker News
Автор отдал ~$800 за 95 часов на двух H100 и ~$400 за API OpenAI. В цифрах бенчмарка эти 95 часов, подозреваю, не учтены — все вендоры БД знают, что их оптимизаторы работали бы лучше, если бы могли позволить себе столько считать.
devsdaHacker News
«Дистилляция с траекторий Astra — достаточное доказательство, что большие модели никуда не уходят». Не опасно ли это признавать, учитывая, как сейчас закрытые и открытые модели обвиняют друг друга в дистилляции?