← Дайджест от 17 сентября 2026
Исследования

 4 источникаHN 216
Одна и та же модель решает разную долю задач в разных агентах — замер Koda
Появился HarnessTax — замер того, насколько результат кодового агента зависит от харнеса, то есть кода вокруг модели: как ставится задача, какие инструменты доступны, как разбирается ответ. Одну и ту же модель прогоняют через разные харнесы и сравнивают долю решённых задач.
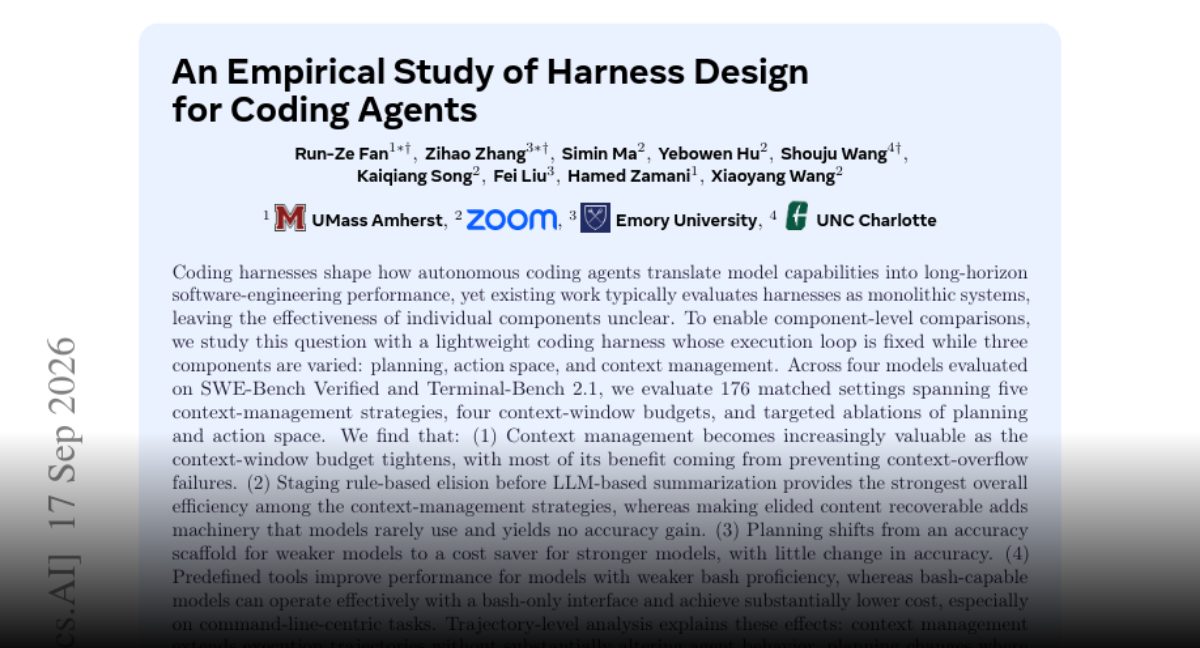
По той же теме вышла эмпирическая работа о проектировании харнесов, отобранная голосами на Hugging Face. Российская команда Koda проверила это на DeepSeek V4 Flash в четырёх популярных харнесах: собственный Koda набрал 52,2% решённых задач и обошёл Kilocode, Claude Code и OpenCode. То есть при выборе агента цифры бенчмарка модели сами по себе ничего не обещают.
Что говорят
jswelkerHacker News
Изрядная часть «лишнего веса» Claude Code и Codex — это, по идее, безопасность и элайнмент. Работает ли оно — вопрос открытый, но выкидывать эти измерения и называть их «налогом» нечестно: так вы просто превращаете небезопасность во внешний эффект. «Зачем платить за вывоз мусора, если в океан бесплатно?» Pi сознательно убирает песочницу и ограничители ради скорости — неудивительно, что он быстрее.
SupermanchoHacker News
Тут словом «харнесс» подменяют «агент», и это тревожит. Значение имеют и контекст, и схема исполнения (параллельно или последовательно), и возможность делегировать другим моделям. Хорошие связки используют параллельный запуск и субагентов и не завязаны на одну модель — анализ по одному харнессу поверхностен и вводит в заблуждение.
ed_mercerHacker News
А на открытые модели вроде GLM 5.3 это распространяется? Получается, простая смена харнесса на Pi вдвое сокращает расходы?