← Дайджест от 19 сентября 2026
Бизнес
 2 источникаHN 198
OpenAI описала, как проектировала свой чип с помощью собственных моделей
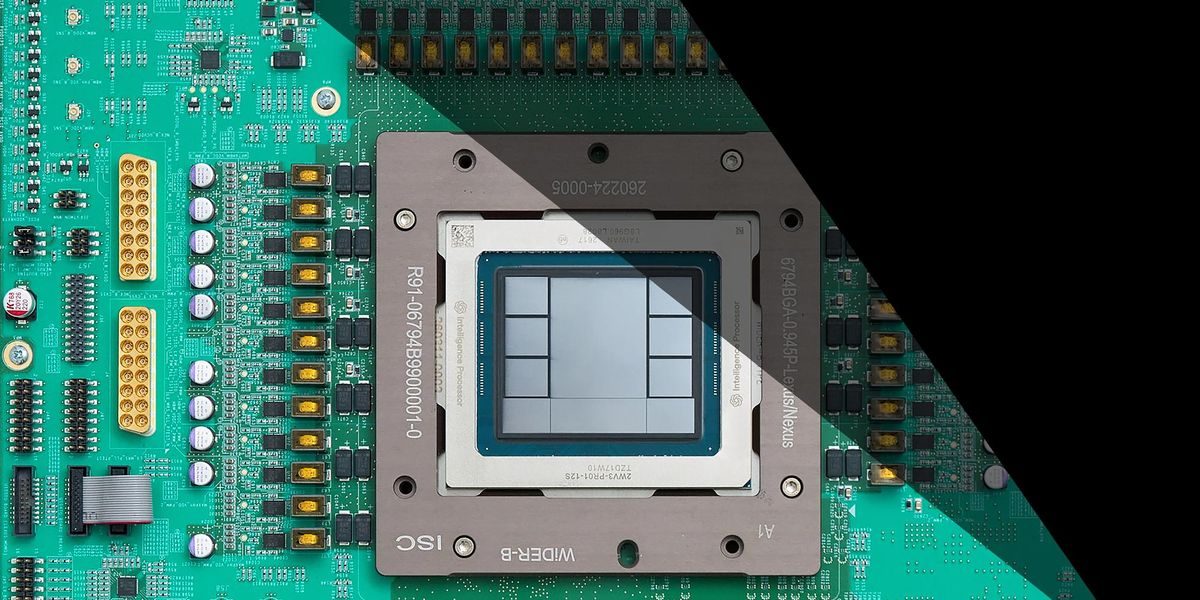
OpenAI рассказала IEEE Spectrum, как использовала собственные языковые модели при проектировании своего чипа Jalapeño. Модели применяли не для генерации схемы целиком, а на отдельных участках маршрута разработки микросхем — там, где инженер тратит время на рутинную работу с описанием логики и проверками.
Это первый подробный рассказ компании о своём железе. Собственный ускоритель решает ровно ту проблему, о которой OpenAI говорит публично: нехватку вычислений под собственные сервисы.
Что говорят
pamaHacker News
Я работал с людьми, которые занимаются запуском специализированных чипов, и поражён тем, как изменился мир. Когда в мае с фабрики пришли первые чипы, внутренние модели натравили на написание софта для бенчмарков: на ядре multi-head latent attention от DeepSeek производительность выросла с 0,31% теоретического потолка до 88,94% примерно за 40 часов, и результат, по словам Хо, воспроизводим.
muchdoubtHacker News
Похоже, OpenAI просто раздувает шумиху вокруг своих моделей, чтобы компании (здесь — разработчики чипов) пользовались ими, а она училась на их интеллектуальной собственности. В статье нигде не сказано, что ИИ сделал что-то творческое — его использовали для разработки софта внутри проекта. Заголовок откровенно вводит в заблуждение.
gozucitoHacker News
Меня удивляет, что рекурсивное самоулучшение сейчас выглядит правдоподобнее, чем в 2023-м. Помню статью 2024 года о том, что галлюцинации нельзя устранить полностью, и панику про исчерпание данных для обучения — а оказалось, люди всё время порождают новые данные, просто добывать их дороже, чем старые.