 4 источникаX 4.0k
LangChain сравнила модель Jev с моделями-судьями по точности, скорости и цене
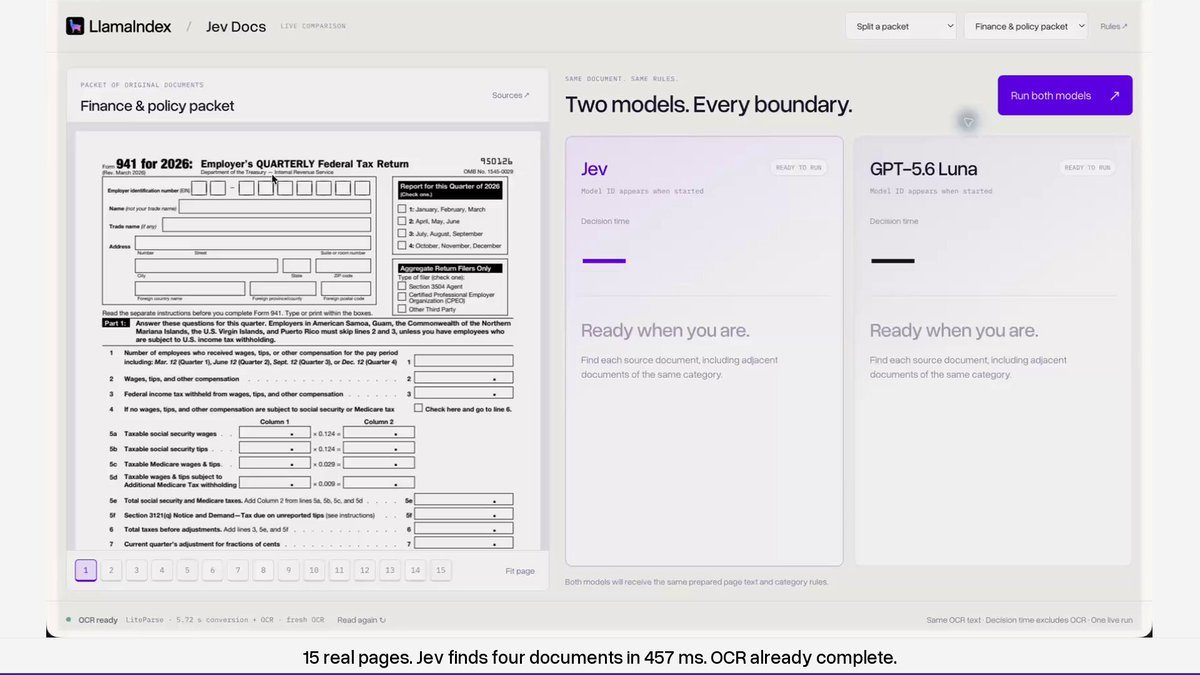
Вчера мы писали про модель Jev от TypeSafe AI, которая не генерирует текст, а выбирает ответ из заданного набора. Сегодня вокруг неё вышли первые проверки и библиотеки.
LangChain прогнала Jev против обычных моделей-судей по четырём параметрам — точность, повторяемость результата, задержка и стоимость — и разбирает, годится ли такой подход для оценки работы агентов. Джерри Лью выложил DocJev, открытую библиотеку, где Jev классифицирует документ или находит границы между склеенными документами по описанным словами правилам; заявлено шестикратное ускорение.
Есть и возражения. Равид Шварц-Зив напомнил, что классификаторы существовали и до 2026 года, «ответов без галлюцинаций» не бывает — бывают ошибки. Делип Рао показал, что типы критериев Jev один в один совпадают с абстракцией его собственной работы autorubric, опубликованной восемью месяцами раньше.
