← Дайджест от 26 сентября 2026
Исследования 1 источникX 84
Инженер LlamaIndex сравнил 16 моделей — рассуждения не помогли разбору документов
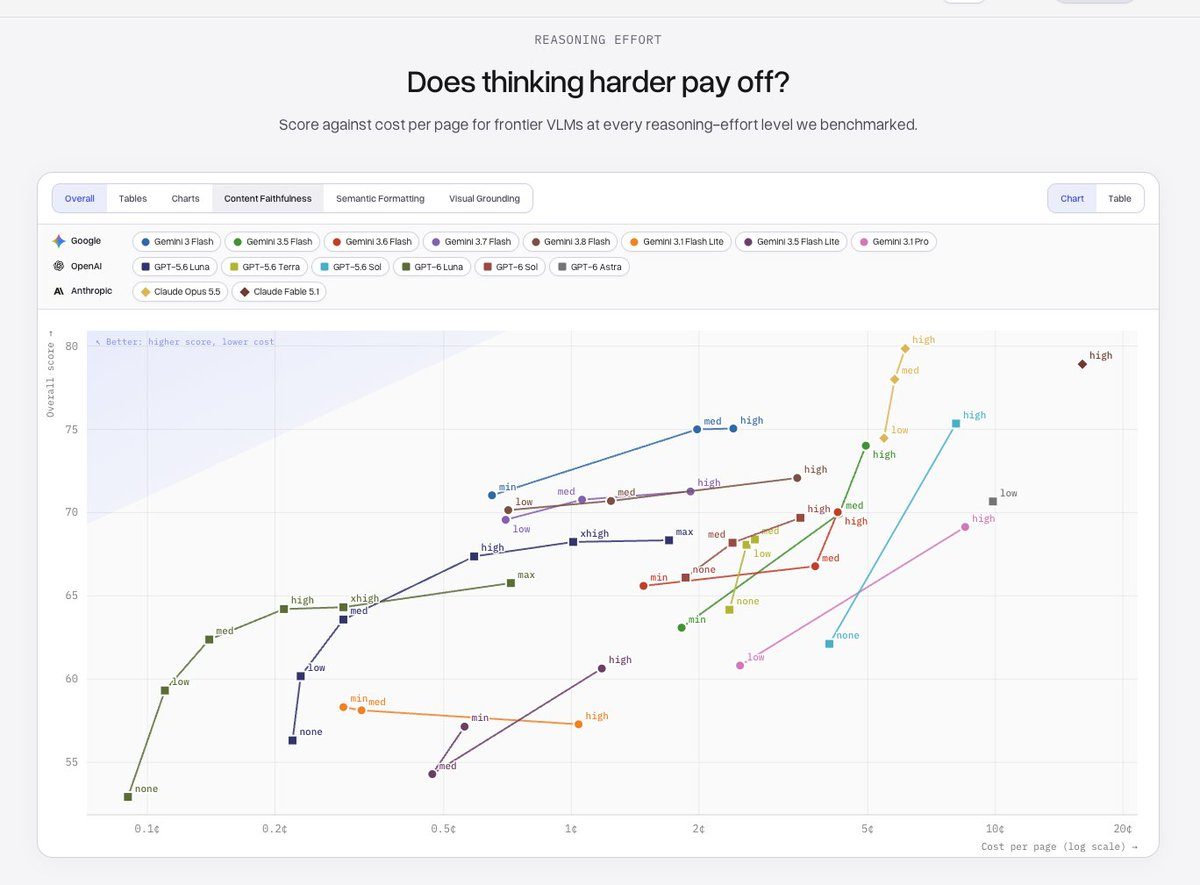
Jerry Liu из LlamaIndex прогнал 16 современных моделей, работающих с картинками и текстом, на разборе документов — и проверил, помогает ли повышенный уровень рассуждений. На задачах по коду и работе со знаниями больше рассуждений обычно даёт прирост.
На разборе документов до недавнего времени связь не работала: модель думала дольше, а таблицы и структуру страницы разбирала не лучше. Сравнение включало Opus 5.5 и GPT-6 Sol и Luna.

Jerry Liu@jerryjliu0
We comprehensively evaluated 16 recent frontier VLMs - including Opus 5.5 and GPT-6 Sol/Luna - on whether higher effort led to better document parsing performance. Higher effort typically leads to improvements on other benchmarks (coding, knowledge work), but up until recently https://t.co/ljRB5edEzG
6826 сентября 2026