← Дайджест от 28 сентября 2026
Исследования 1 источникX 1.8k
Meta заявила, что научилась убирать пустой машинный текст методом RL-XAR
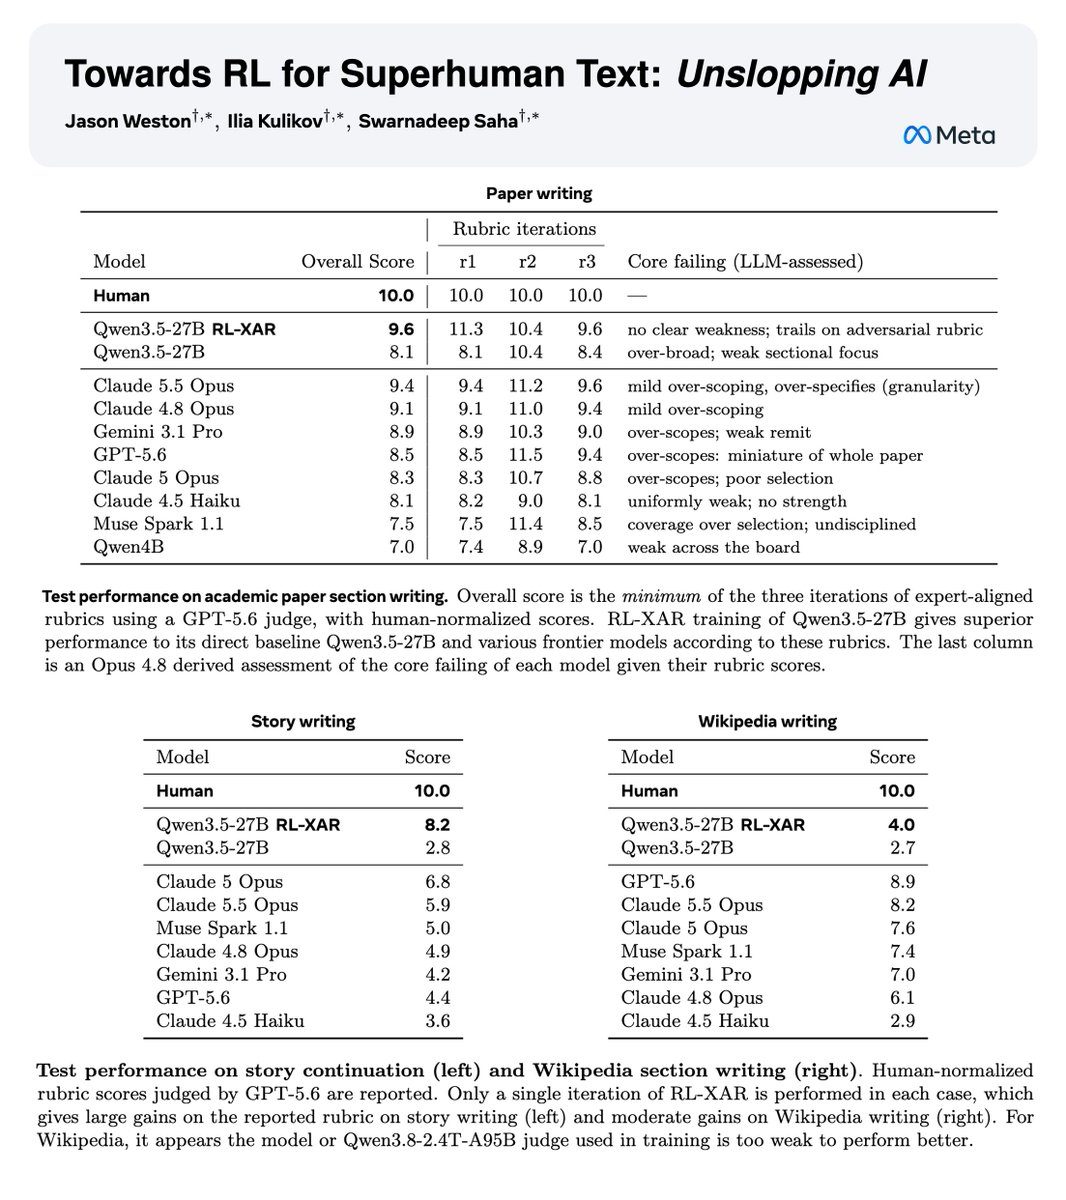
Команда Джейсона Уэстона из Meta заявила, что решила проблему «ИИ-слопа» — гладкого, но пустого машинного текста. Метод назвали RL-XAR: обучение с подкреплением по критериям, снятым с экспертов.
Идея в том, чтобы взять тексты профессиональных авторов и вывести из них правила, которые описывают разрыв между экспертом и моделью. Дальше модель учат именно по этим правилам, а не по общей оценке «нравится — не нравится».
Заявление громкое, и проверять его будут другие: пока опубликованы блог-пост и описание метода.

Jason Weston@jaseweston
Claim: we've solved the AI slop problem (!) 💩🧹✨ Blog post: https://t.co/SPP574KfJz 🧵1/5 Key idea: take *expert* human writing and learn rubrics that find the gap between experts and models. Train with those rubrics. We train with RL-XAR (RL with eXpert Aligned Rubrics) & https://t.co/SJf5v2Zvbc
1 55528 сентября 2026