← Дайджест от 9 октября 2026
Модели 1 источник
Инженер полтора месяца правил движок llama.cpp и проиграл его штатному флагу
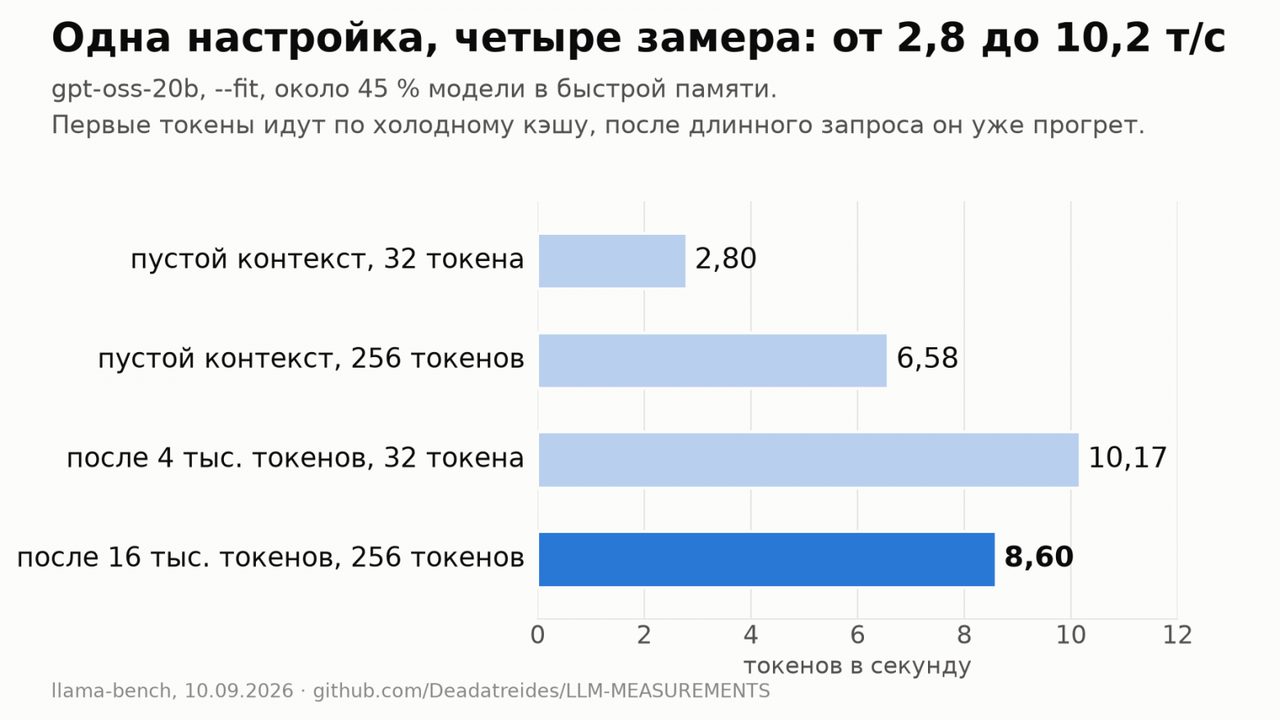
Инженер-тепломеханик полтора месяца пытался ускорить большие MoE-модели на домашнем компьютере с видеокартой на 6 ГБ. MoE — модель, где на каждый запрос работает только часть слоёв, поэтому её можно держать частично в оперативной памяти и даже на диске.
Полигоном была gpt-oss-20b, железо — GTX 1660 SUPER, 24 ГБ оперативной памяти и обычный SATA-диск. Автор правил форк llama.cpp, подбирая, какие части модели держать на видеокарте.
Итог он называет обидным: ни одна его правка не обогнала штатный флаг самой llama.cpp, который делает то же самое из коробки. Вывод для тех, кто повторяет: прежде чем патчить движок, стоит перебрать его собственные ключи запуска.