← Дайджест от 13 октября 2026
Модели 2 источникаHN 400
Разработчики научили поисковую модель EmbeddingGemma 2 распознавать речь
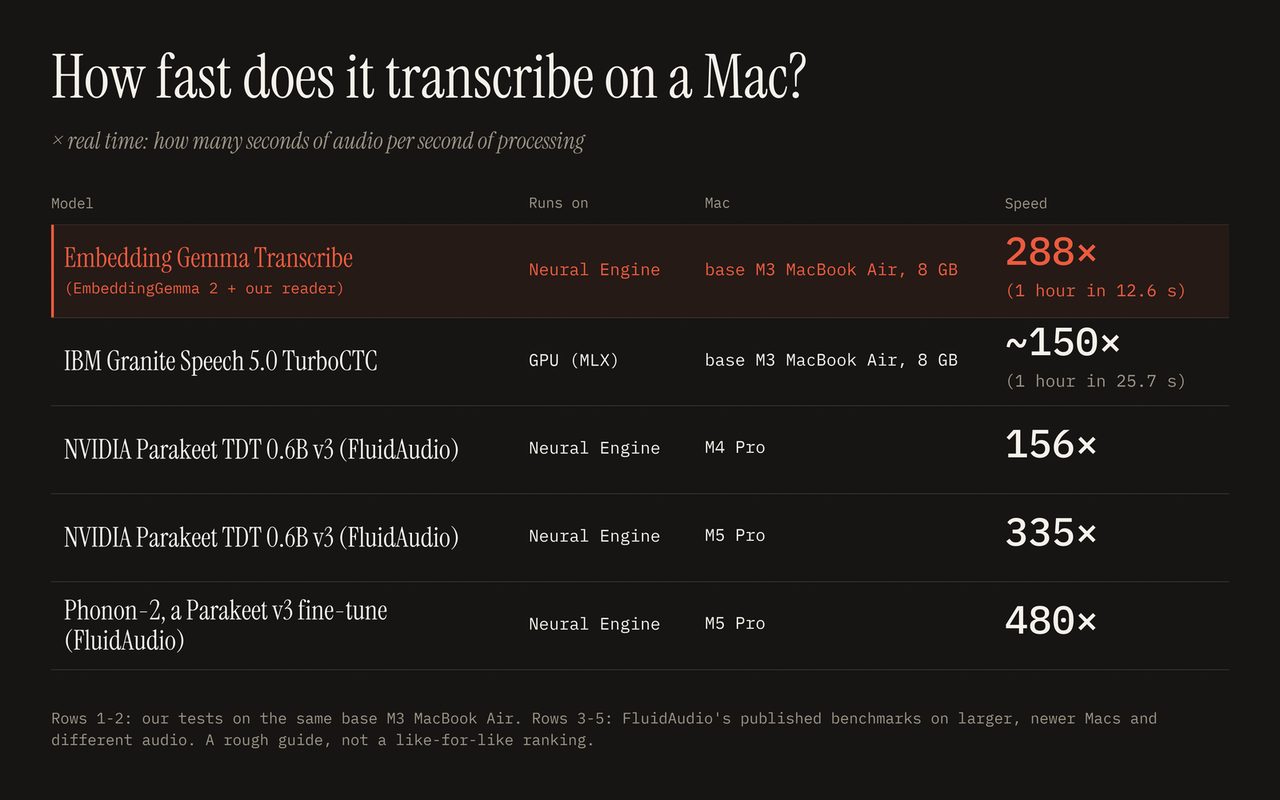
Разработчики переделали EmbeddingGemma 2 — компактную модель Google для поиска по смыслу — в систему распознавания речи. Исходно модель умеет только превращать текст и звук в числовые векторы для поиска, генерировать текст она не обучена.
Авторы приделали к ней декодер и дообучили связку, получив расшифровку речи на базе, не предназначенной для этой задачи. В обсуждении на Hacker News разбирают, за счёт чего это вообще работает: звуковые векторы модели оказались достаточно информативными, чтобы по ним восстанавливался текст, хотя её учили только на сопоставление.
Что говорят
mikemzz1Hacker News
Интересный подход, но если обучить CTC-голову поверх аудиоэнкодера Gemma, результаты будут лучше, а инференс быстрее.
ImustaskforhelpHacker News
Очень вовремя, но работает ли это с хинди и другими неанглийскими языками? Я недавно расшифровывал смешанное аудио на хинди и английском, и на 90 минут ушёл примерно час — хотелось бы такой же поддержки для большего числа языков.
alberthHacker News
Я совсем не разбираюсь, как это устроено: получается, аудио надо прогонять на скорости 200x, чтобы транскрибировать так быстро? Или есть другой подход?