← Дайджест от 6 ноября 2026
Исследования 1 источник
Почти половина ИИ-отчётов о встречах получала тройку и ниже — разбор «Атома»
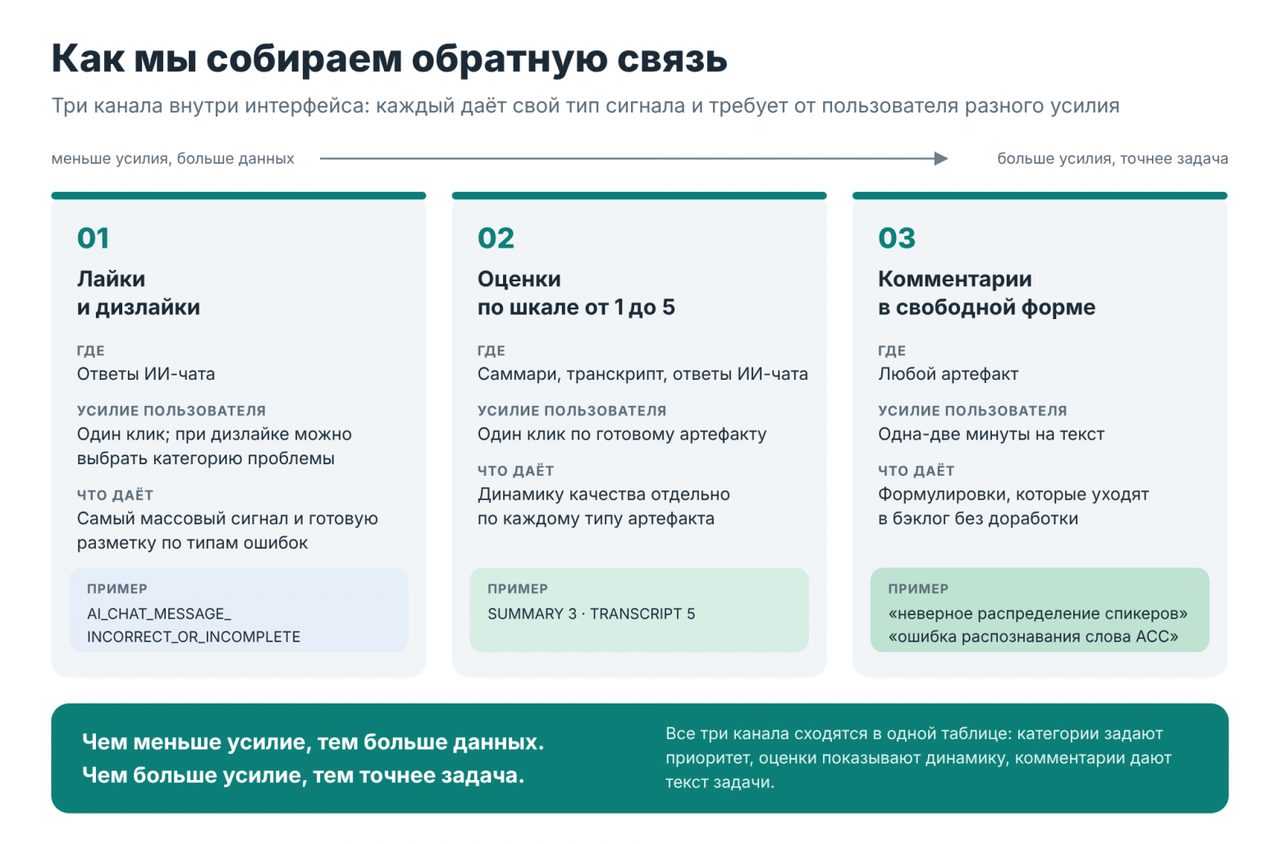
Команда «Атом» разобрала, почему 45% их ИИ-отчётов о рабочих встречах получали тройку и ниже по внутренней пятибалльной оценке. Сначала пришлось научиться считать: кто вообще пользуется сервисом, возвращается ли, какие встречи попадают на расшифровку.
Оказалось, что низкие оценки концентрируются не в качестве модели, а во входных данных — плохая запись, несколько говорящих поверх друг друга, встречи без внятной повестки. Команда описала набор метрик, по которым теперь отделяет проблемы распознавания от проблем суммаризации.