← Дайджест от 14 ноября 2026
Бизнес
 2 источникаHN 130
Nvidia запустила большую модель GLM-5.3 на двух станциях DGX вместо кластера
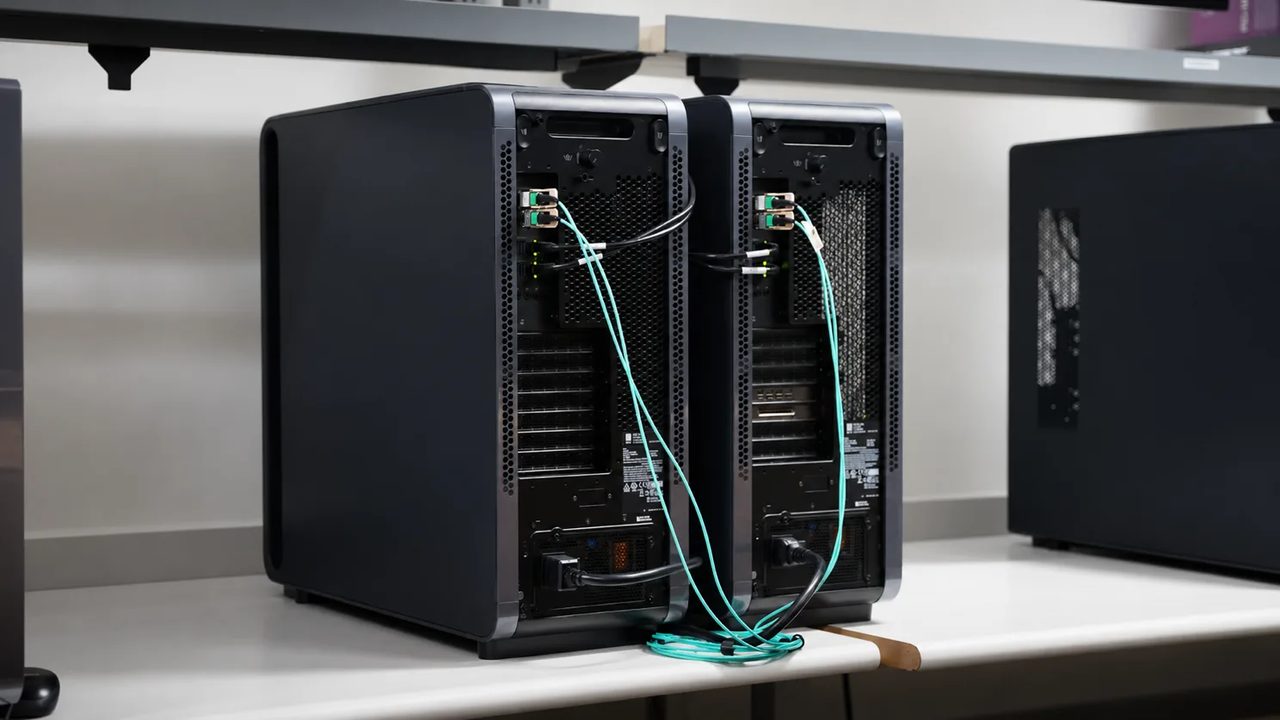
Nvidia инженеры показали, как раздать модель GLM-5.3 на двух рабочих станциях DGX через vLLM — сервер для выполнения запросов к моделям — и получили 607,8 токена в секунду суммарно.
Смысл замера в том, что модель не помещается в память одной станции. Работу распределили между двумя машинами, разложив слои по устройствам, и при этом сохранили приемлемую скорость ответа.
Это сценарий для команд, которым нужна большая модель на своём железе без закупки стойки целиком: две станции вместо кластера.