← Дайджест от 19 сентября 2026
Исследования
 3 источникаX 1.3k
DeepSeek выпустила модель V4.1-Flash, которая сильнее сжимает память о диалоге
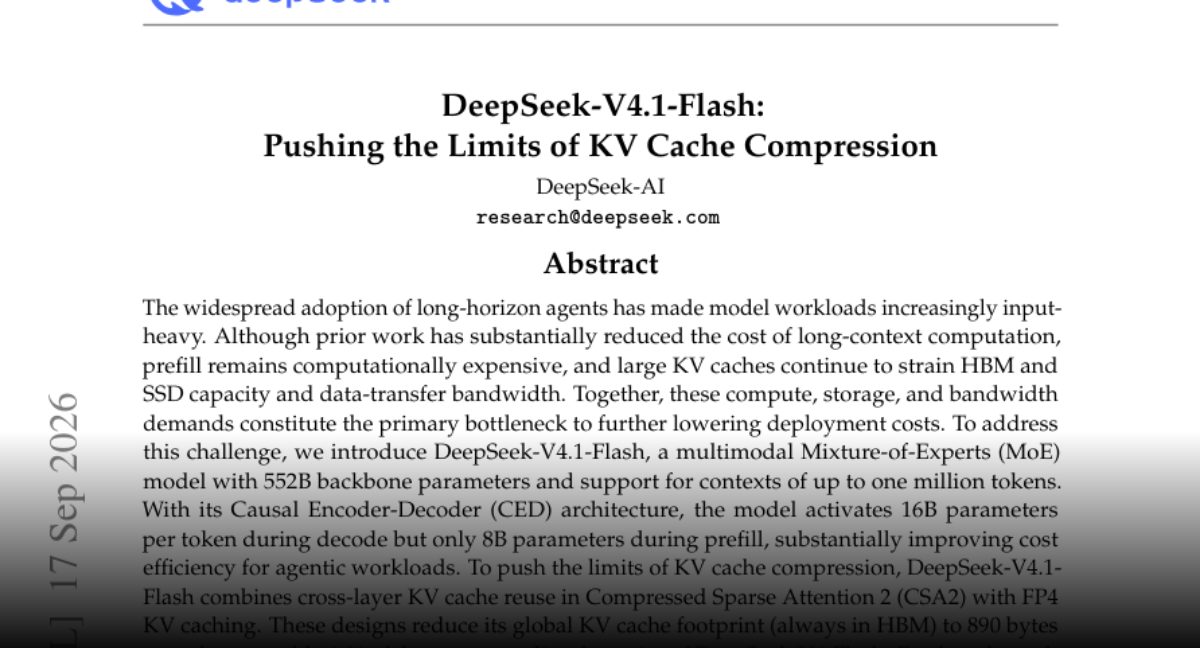
DeepSeek опубликовала DeepSeek-V4.1-Flash — работу о предельном сжатии KV-кеша, памяти, где модель хранит уже обработанную часть диалога. Именно этот кеш растёт линейно с длиной разговора и съедает видеопамять при длинных контекстах.
В статье описаны таблицы Engram — механизм, который разработчик Suhail назвал самой интересной частью релиза: по сути всё сводится к сжатию, а поверх него к кешированию. Практический эффект уже виден в отзывах инженеров: Юйчэнь Цзинь называет V4.1 Flash своим выбором для простых и средних задач — «безумно быстро и дёшево».

Yuchen Jin@Yuchenj_UW
My model + harness stack these days: 1. Kimi K3 is the best OSS coding model. GLM-5.3 is next. 2. DeepSeek V4.1 Flash is my pick for easy/moderate tasks: insanely fast and cheap. 3. I reach for Astra for complex tasks. 4. Codex works better with OSS models. Claude Code can make
1 17519 сентября 2026