← Дайджест от 24 сентября 2026
Модели
 2 источникаHN 146
Модель Mercury 2.5 отвечает быстрее, чем человек читает, — замер Artificial Analysis
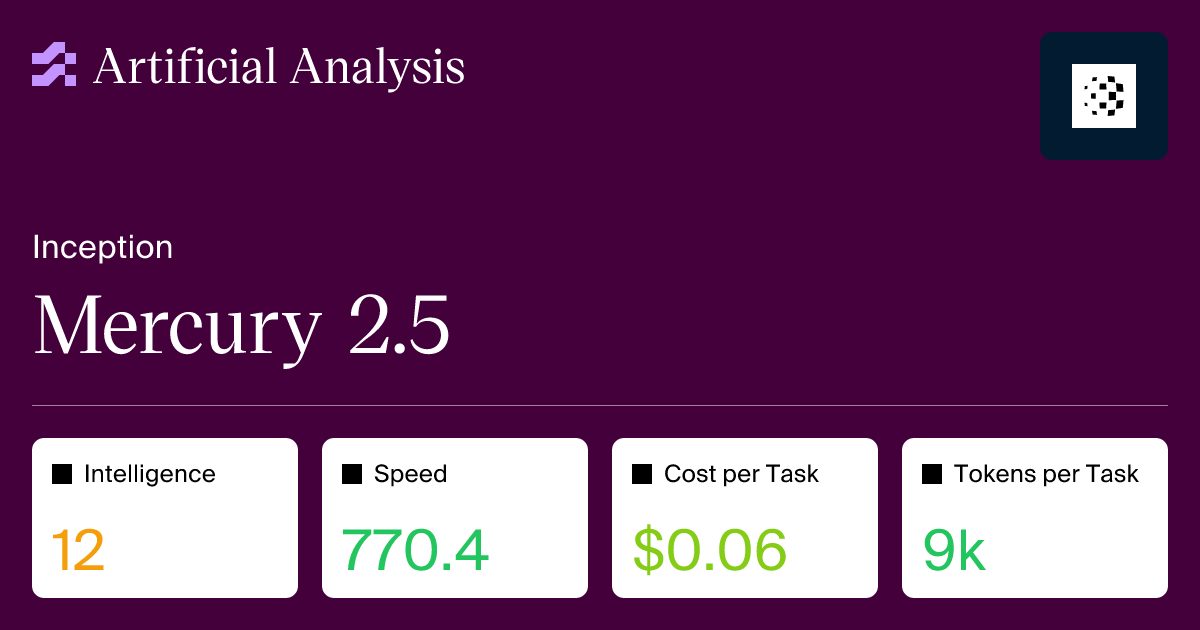
Модель Mercury 2.5 показала 770 токенов в секунду в замере Artificial Analysis — независимого сервиса, который меряет скорость и цену моделей. Токен — кусок текста примерно в три-четыре символа, то есть речь о нескольких сотнях слов в секунду.
Это заметно выше типичной скорости больших моделей и попадает в тот диапазон, где ответ появляется быстрее, чем человек успевает прочитать предыдущую строку. Для сценариев вроде голосовых помощников и автодополнения кода скорость решает не меньше качества.
В обсуждении на Hacker News спорят, за счёт чего достигнута цифра и как она держится при длинном контексте.
Что говорят
nylonstrungHacker News
Честно говоря, считаю диффузионные LLM тупиком. Показательно, что передовые лаборатории вроде Google поигрались и не стали вкладываться дальше даже в самых чувствительных к скорости и цене маленьких моделях. До сих пор непонятно, для каких сценариев это вообще парето-оптимально.
walrus01Hacker News
Цена $0,25 и $0,75 уже выше, чем у приличных провайдеров инференса для deepseek v4 flash или qwen 3.8-flash-next и похожих open-weight моделей, влезающих в 170 ГБ памяти. Смысла не вижу.
bearjawsHacker News
Если важна скорость — Cerebras с gpt-oss-120b выдаёт 1400 токенов/с и по рейтингу «столь же умна». Пробовал на паре проектов для развлечения: нормально, но за скоростью просто завораживающе наблюдать.