← Дайджест от 4 октября 2026
Инструменты

 3 источникаHN 624X 2.1k
Вышел Strata — набор, который запускает большую модель Qwen на домашней видеокарте
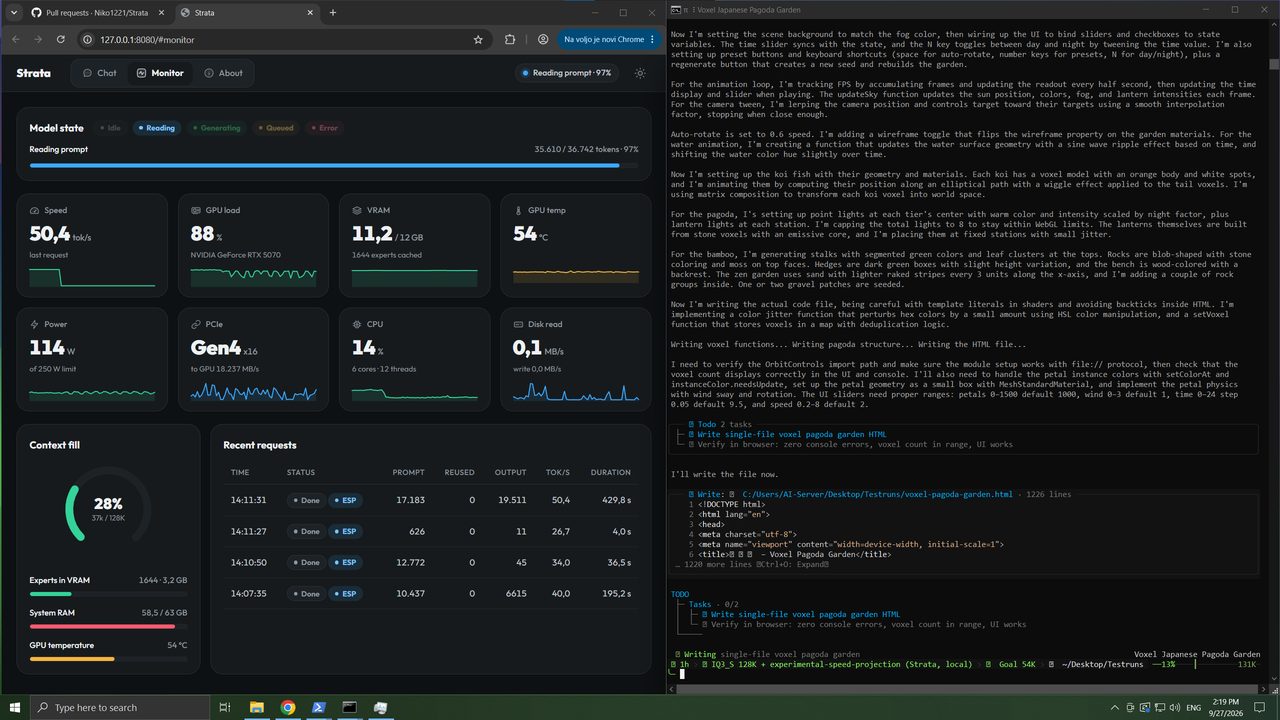
На GitHub вышел Strata — набор, который запускает модель Qwen 3.8 Flash Next на 125 млрд параметров на одной домашней видеокарте RTX 4090 со скоростью около 100 токенов в секунду. Обычно модель такого размера требует нескольких серверных ускорителей.
Трюк в том, что у Qwen 3.8 Flash Next одновременно работает лишь малая часть весов, а остальные можно держать в обычной оперативной памяти и подгружать по мере надобности. Репозиторий за сутки собрал 624 очка на Hacker News, в комментариях уточняют требования к объёму памяти и к скорости шины.
Виталик Бутерин в тот же день описал свой сценарий с этой моделью: локальная Qwen разбирает личные медицинские и геоданные, а наружу к большим моделям уходят только обезличенные вопросы.

vitalik.eth@VitalikButerin
Doing a bit of a self-experiment. Goal: use my personal health and travel data to provide personalized diet and exercise recommendations for me, using frontier models but in a way that avoids leaking to them any private information. Strategy: use a local model (Qwen 3.8 Flash https://t.co/mi38E5jlfN
1 8044 октября 2026
Что говорят
sneheshtHacker News
Попробовал — работает на удивление хорошо. На моей машине (Nvidia 4090, 128 ГБ DDR5, Ryzen 7950X3D) выходит 124 токена в секунду.
quietFalconHacker News
Неплохо, но скорость генерации — это простая половина задачи при выгрузке MoE на CPU. А как обстоят дела с обработкой промпта, скажем, на 16k контекста?
esafakHacker News
Кто-нибудь считал реальный уровень интеллекта этих квантованных моделей? По-моему, публиковать бенчмарки именно для квантованных версий пора сделать стандартной практикой.