← Дайджест от 8 ноября 2026
Исследования 1 источник
Модель в сотни раз меньше обошла Llama-3 70B — замеры команды Яна Лекуна
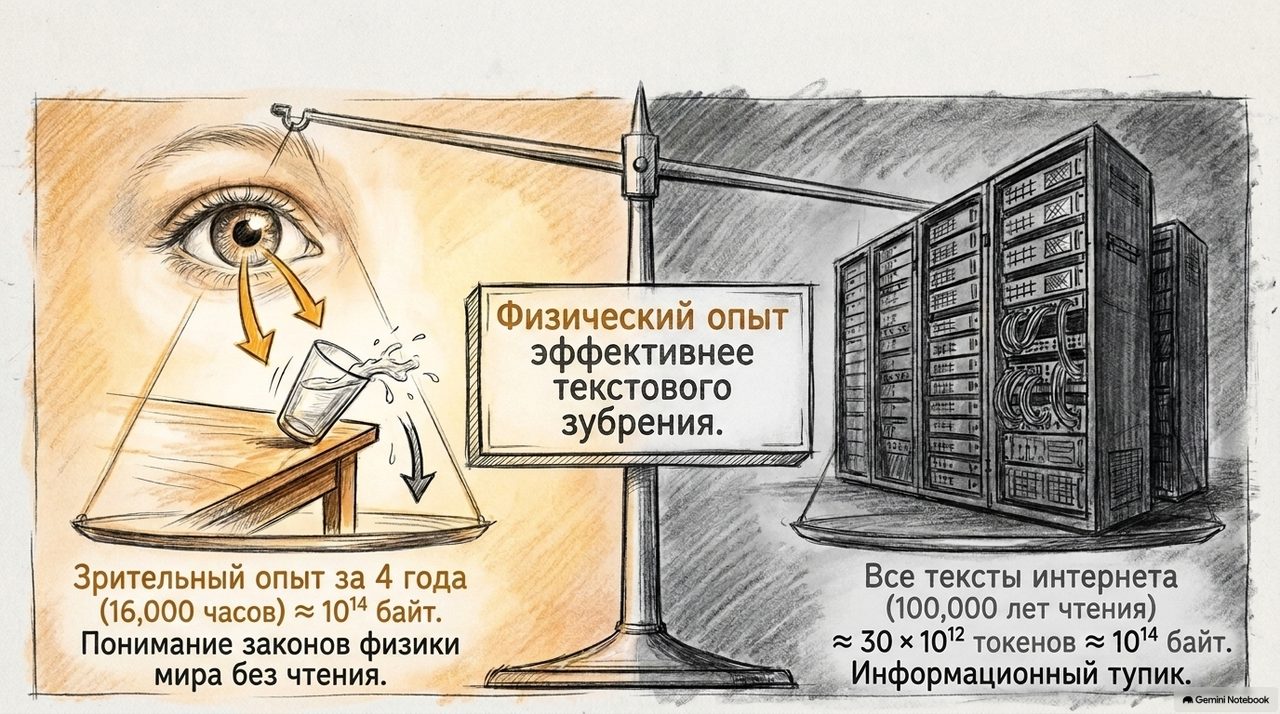
Автор Хабра разобрал статью Яна Лекуна и Рэнделла Балестриеро про JEPA — способ обучения, при котором модель предсказывает не следующее слово, а внутреннее представление пропущенного фрагмента. По его изложению, небольшая модель на этом подходе обходит Llama-3 70B на части задач при размере в сотни раз меньше.
Довод авторов в том, что предсказание следующего слова тратит вычисления на поверхностные детали, а предсказание представления заставляет модель строить устойчивую картину данных.
Замеры сделаны самими авторами подхода и сравнивают разные по назначению модели, независимых проверок пока нет.